MySQL架构和性能优化
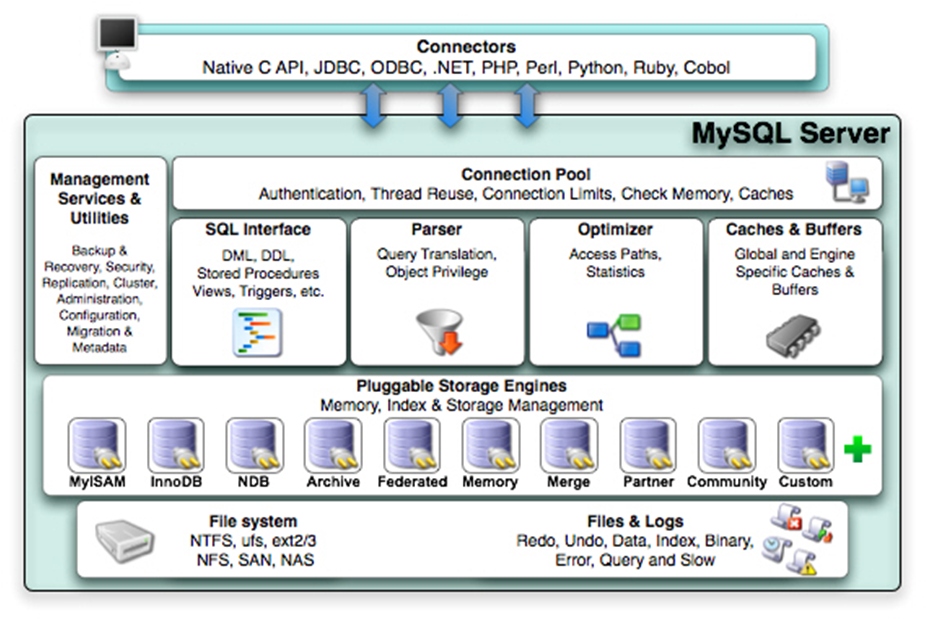
MySQL 是 C/S 架构,上图是 MySQL 的架构图,从上到下:
connectors:连接器,编程语言角度可以理解为连入数据库的驱动,mysql 角度称作专用语言对应的链接器
connection pool:mysql 是单进程多线程模型,每个用户连接,都会创建一个单独的连接线程,connection pool 的作用就是维护线程池,管理众多线程应对众多客户端的并发请求,完成并发相应,对于 mysql,它实现的功能包括:
- authentication:用户认证,校验账号密码
- thread reuse:线程重用,用户退出后,线程有可能并非被销毁,而是把它清理完以后,重新收归到线程池当中的空闲线程中去,以完成所谓的线程重用
- connection limit:限制线程池的线程数量,决定并发连接的数量,超过上限则排队或拒绝
- check memory:检测内存
- caches:线程缓存
SQL Interface:SQL 解释器 或 SQL 接口,可以理解为 mysql 的外壳,就像 shell 是 linux 的外壳一样。对 SQL 语句做词法分析、句法分析
parser:分析器,解释器分析语法是否有错误,分析器做执行分析,或者加查询翻译,例如 connection pool 校验用户是否合法,parser 检查用户是否有操作权限
optimizer:查询优化器,提高 SQL 的执行效率
caches & buffers:从 mysql8.0 开始已被取消,推荐使用 Redis、Memcached 等软件
pluggable storage engines:插件式存储引擎
- MySAM:MySQL 经典的存储引擎
- InnoDB:Innobase Oy 公司开发,2006 年五月由甲骨文公司并购提供给 MySQL
- NDB:主要用于 MySQL Cluster 分布式集群环境
- Archive:做归档
- …
file system:
files & logs:
MySQL 还提供管理和服务工具,例如:备份和恢复工具,安全工具,复制工具,集群服务,管理、配置、迁移、元数据等工具
存储引擎
MyISAM
- 不支持事务,所以崩溃恢复性较差
- 表级锁定
- 读写相互锁定,写入时不能读,读时不能写
- 不支持外键
- 读取数据快,占用资源少
- 不支持 MVCC(多版本并发控制机制)高并发
数据库文件:
- tbl_name.frm:储存数据表定义
- tbl_name.MYD:存储数据
- tbl_name.MYI:存储索引
InnoDB
Innodb 和 MyISAM 的主要区别在于是否支持事务,其他的区别只是表面区别,根本原因还是是否支持事务导致的
- 行级锁
- 支持事务,所以崩溃恢复性好
- 读写阻塞与事务隔离级别相关
- 支持 MVCC 高并发
数据库文件:
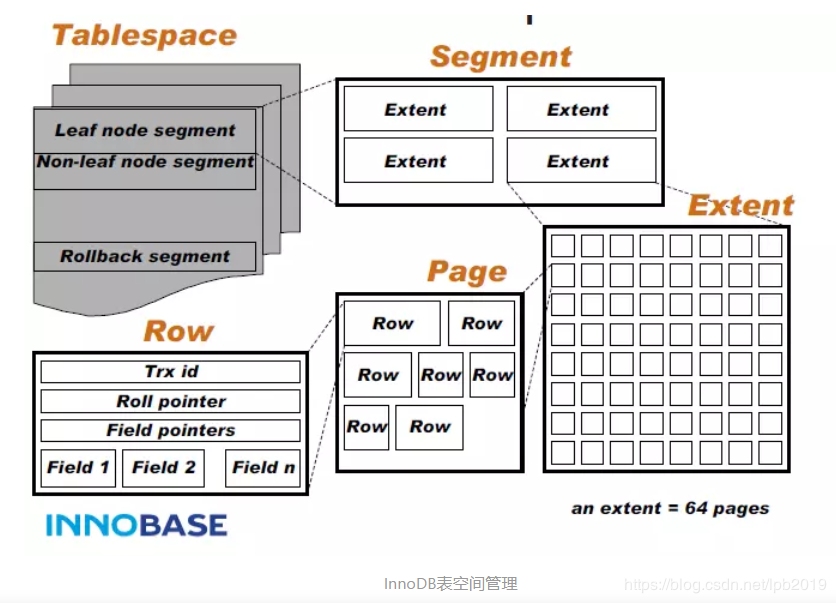
innodb 读取数据是以 page 为单位
innodb_file_per_table = ON(mysql5.6.6 后默认开启)设置独立表空间:
- tbl_name.frm:储存数据表定义
- tbl_name.ibd:存储数据和索引,myisam 把数据和索引分开存储,而 innodb 存储在一起
innodb_file_per_table = OFF 设置共享表空间:
- tbl_name.frm:储存数据表定义
- ibdata1:所有表的数据和索引都存储在 ibdata1 中,默认位于 datadir 目录下
关于 ibdata1 文件:
ibdata1 是共享表空间,设置 innodb_file_per_table = ON 后,ibdata1 还会增长,那其中存储的数据是什么呢?不太清楚…
其他存储引擎
Performance_Schema、Memory、MRG_MyISAM、Archive、Federated 联合、BDB、Cluster/NDB、CSV、BLACKHOLE、example
管理存储引擎
- 查看
1 | # 查看mysql支持的存储引擎 |
- 设置
1 | # 设置默认的存储引擎 |
系统数据库
mysql
是 mysql 的核心数据库,类似于 Sql Server 中的 master 库,主要负责存储数据库的用户、权限设置、关键字等 mysql 自己需要使用的控制和管理信息performance_schema
MySQL 5.5 开始新增的数据库,主要用于收集数据库服务器性能参数,库里表的存储引擎均为 PERFORMANCE_SCHEMA,用户不能创建存储引擎为 PERFORMANCE_SCHEMA 的表information_schema
MySQL 5.0 之后产生的,一个虚拟数据库,物理上并不存在 information_schema 数据库类似与“数据字典”,提供了访问数据库元数据的方式,即数据的数据。比如数据库名或表名,列类型,访问权限(更加细化的访问方式)sys
MySQL5.7 之后新增加的数据库,库中所有数据源来自 performance_schema。目标是 performance_schema 的把复杂度降低,让 DBA 能更好的阅读这个库里的内容。让 DBA 更快的了解 DB 的运行情况
服务器配置和状态
服务器选项
- 查看 mysqld 可用选项列表及当前值
1 | mysqld --verbose --help |
- 获取 mysqld 当前启动选项
1 | mysqld --print-defaults |
服务器系统变量
分为全局和会话两种:
1 | # 查看所有系统变量 |
修改变量:仅对修改后新创建的会话有效;对已经建立的会话无效
1 | # 修改全局变量 |
注意:选项 和 变量长得很像,不要搞混,选项和变量使用中使用下划线_或者横线-都可以,但是默认变量使用下划线,选项使用横线,这点在使用 grep 查询的时候要注意
选项列表:mysqld --verbose --help
变量列表:show variables;
变量修改都是临时性的,重启服务就失效了,要想永久设置,需要修改或添加配置文件(my.conf)中的相关选项
SQL_MODE
SQL_MODE:对其设置可以完成一些约束检查的工作,可分别进行全局的设置或当前会话的设置
常见 MODE:
- NO_AUTO_CREATE_USER: 禁止 GRANT 创建密码为空的用户
- NO_ZERO_DATE:在严格模式,不允许使用’0000-00-00’的时间
- ONLY_FULL_GROUP_BY: 对于 GROUP BY 聚合操作,如果在 SELECT 中的列,没有在 GROUP BY 中出现,那么将认为这个 SQL 是不合法的
- NO_BACKSLASH_ESCAPES: 反斜杠“\”作为普通字符而非转义字符
- PIPES_AS_CONCAT: 将”||”视为连接操作符而非“或”运算符
变量只能临时修改,所以选项也提供了 sql_mode,以便可以永久修改
1 | # sql_mode 变量 |
服务器状态变量
分为全局状态 和 会话状态,状态变量是只读的,用于保存 mysqld 运行中统计数据的变量,不可更改
1 | SHOW [SESSION] STATUS; |
查询缓存
了解即可,MySQL8.0 中已经取消了查询缓存
索引
索引的类型
关于索引的类型,这部分比较难,先跳过吧,等学学数据结构再回来看\
索引会失效的情况
列与列对比:某个表中,有两列(id 和 c_id)都建了单独索引,下面这种查询条件不会走索引
1
select * from test where id=c_id;
索引设置的列中出现了 NULL 值,此列在使用时不会使用索引
<>、NOT、in、not exists 这类查询条件为非时,索引定位很困难
1
2
3
4select * from test where id<>500;
select * from test where id in (1,2,3,4,5);
select * from test where not in (6,7,8,9,0);
select * from test where not exists (select 1 from test_02 where test_02.id=test.id);LIKE 模糊搜索时,前置通配符会让索引失效,例如查询姓张的人
like 张%会走索引,但是查询叫明的人like %明,索引会失效对索引使用计算,可能会让索引失效,例如:
1
2
3
4select * from test where upper(name)='SUNYANG'; # 索引失效
select * from test where name=upper('sunyang'); # 没有对索引进行计算,所以索引不失效
select * from sunyang where id/2=:type_id; # 索引失效
select * from sunyang where id=:type_id*2; # 没有对索引进行计算,所以索引不失效复合索引前导列区分大,前导列区分度大,且查后导列的时候,前导列的分裂会非常耗资源,执行计划想,还不如全表扫描来的快,然后就索引失效了
当查询条件存在隐式转换时,索引会失效。比如在数据库里 id 存的 number 类型,但是在查询时,却用了下面的形式:
1
select * from sunyang where id='123';
索引优化
- 对于经常在 where 子句使用的列,最好设置索引
- 对于有多个列 where 或者 order by 子句,应该建立复合索引
- 不要在索引列上进行运算(函数操作和表达式操作)
- 尽量使用短索引,如果可以,应该制定一个前缀长度
- 多列索引:AND 操作时更适合使用多列索引,而非为每个列创建单独的索引
- 索引的最左前缀原则
- 选择合适的索引列顺序:无排序和分组时,将选择性最高放左侧
- 每个列都要设置
NOT NULL,并设置 DEFAULT 值,并且 DEFAULT 值不要设置空串,可以给一个空格 - LIKE 语句,尽量使用后置通配符,不要使用前置通配符
- 尽量不要使用<>、NOT、in、not exists 操作,虽然可能使用索引,但性能不高
- 查询时,能不要 *就不用 *,尽量写全字段名,比如:
select id,name,age from students; - 大部分情况连接效率远大于子查询,但是数据量大的时候,连接要尽量不要用
- 在有大量记录的表分页时使用 limit
- 多使用 explain 和 profile 分析查询语句
- 查看慢查询日志,找出执行时间长的 sql 语句优化
优化表空间
1 | OPTIMIZE TABLE tb_name; |
管理索引
给已存在的表添加索引:
1 | ALTER TABLE tbl_name ADD INDEX index_name(index_col_name[(length)]); |
删除索引:
1 | DROP INDEX index_name ON tbl_name; |
查看索引:
1 | SHOW INDEXES FROM [db_name.]tbl_name; |
EXPLAIN 工具
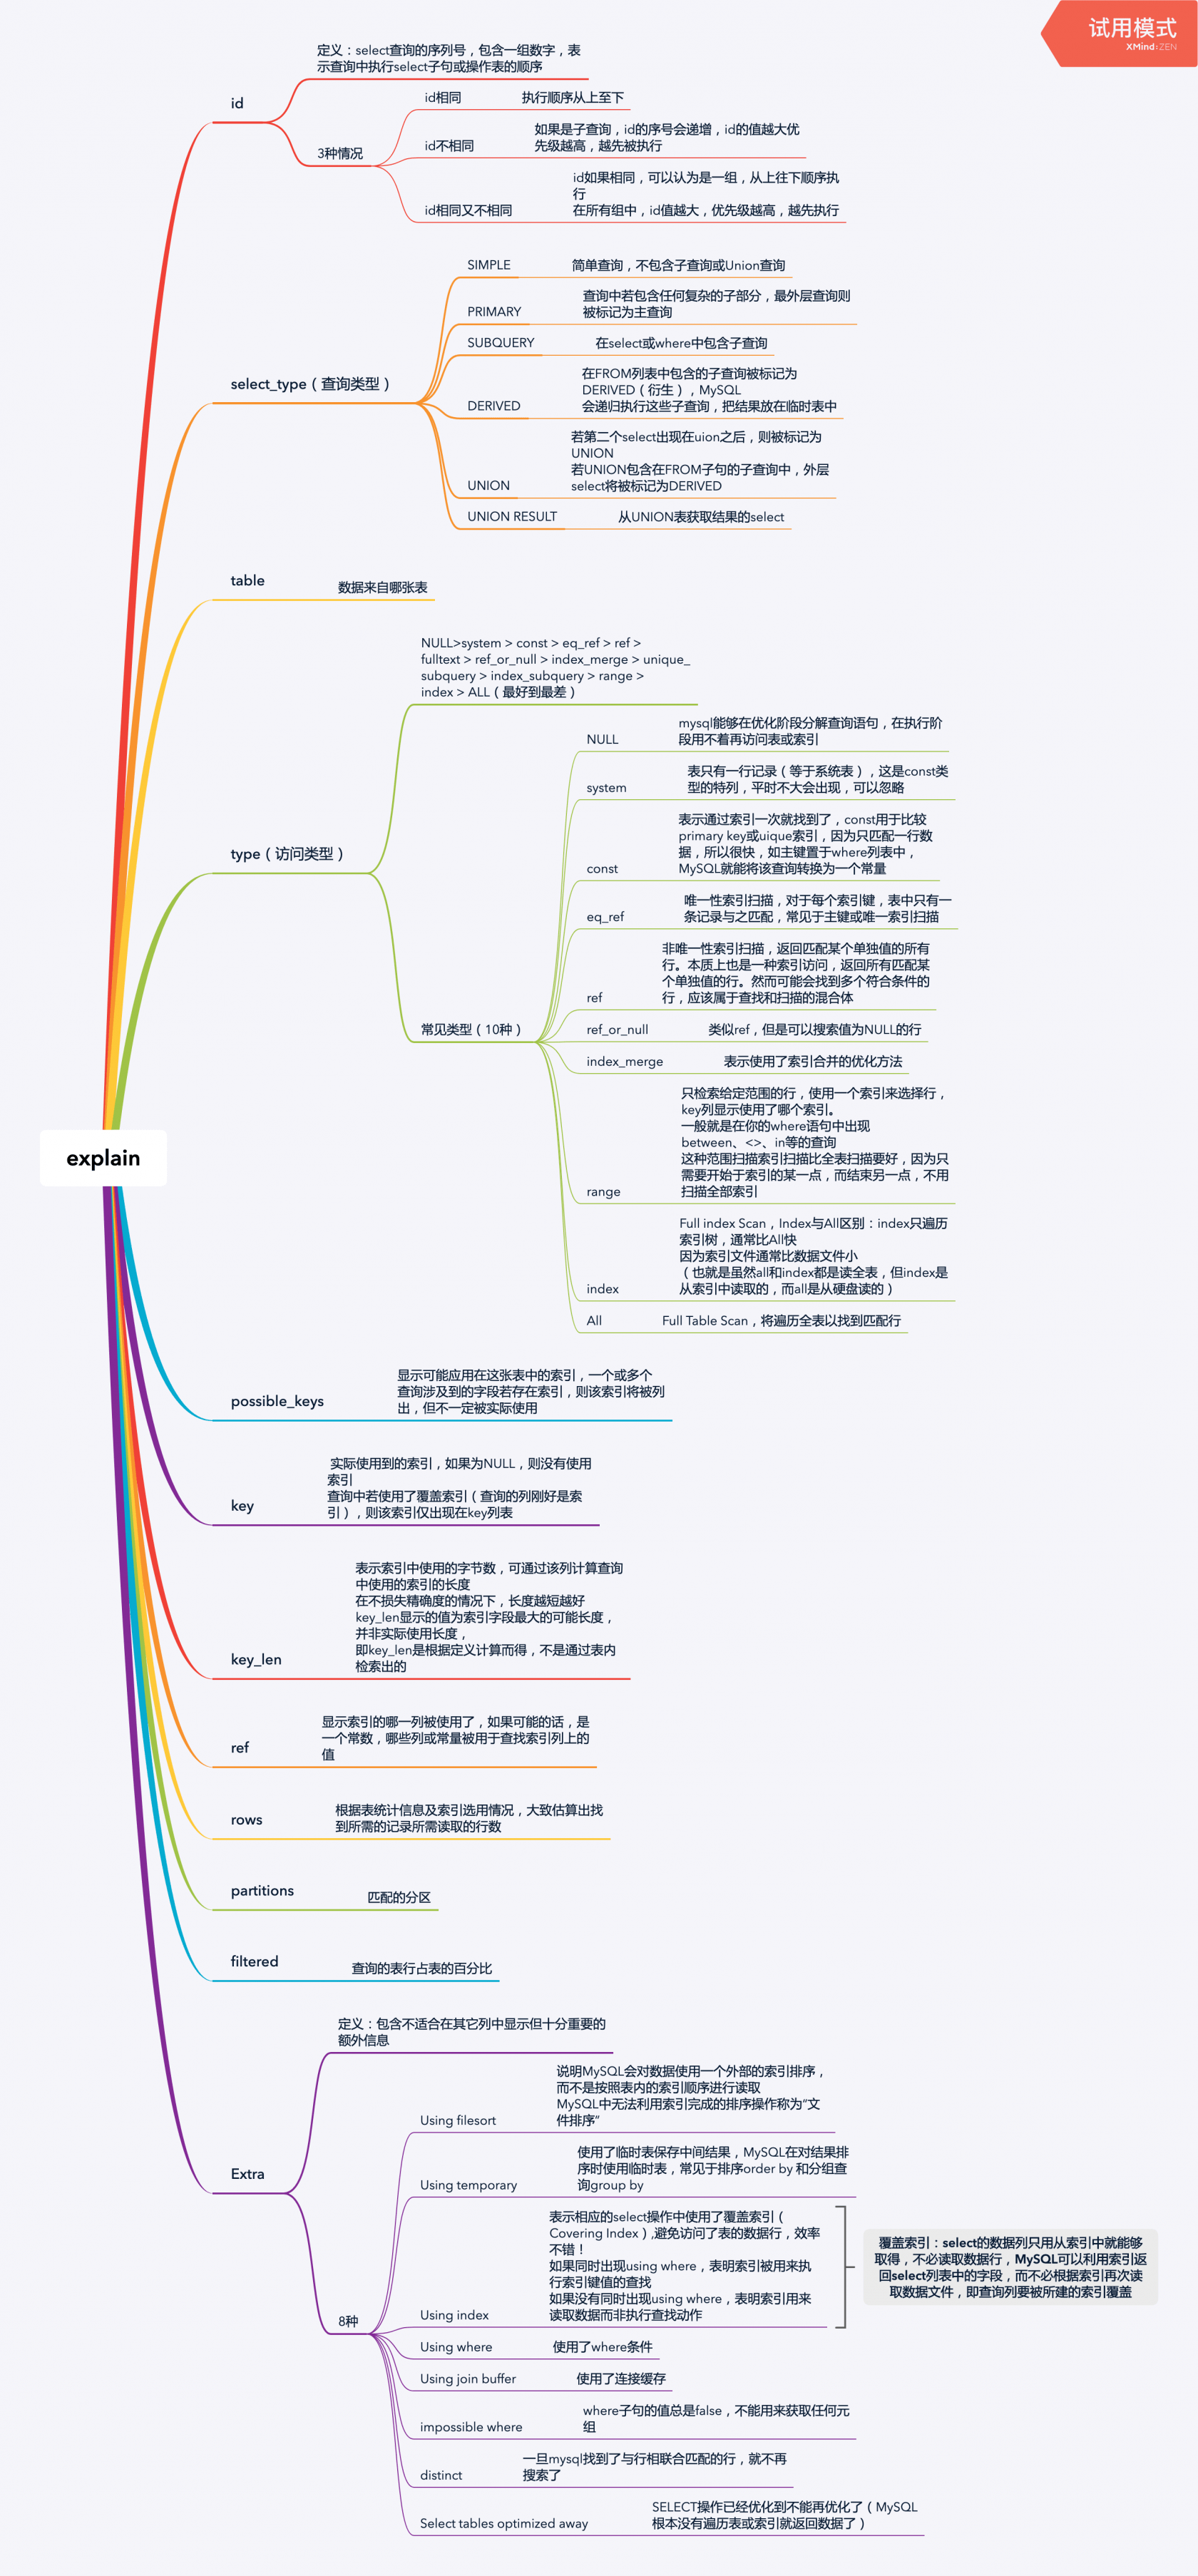
可以通过 EXPLAIN 来分析索引的有效性,获取查询执行计划信息,用来查看查询优化器如何执行查询。
参考资料: https://dev.mysql.com/doc/refman/5.7/en/explain-output.html
语法:
1 | explain 查询语句 |
示例:

explain 输出信息说明:
| 列名 | 说明 |
|---|---|
| id | 执行编号,标识 select 所属的行。如果在语句中没子查询或关联查询,只有唯一的 select,每行都将显示 1。否则,内层的 select 语句一般会顺序编号,对应于其在原始语句中的位置 |
| select_type | - 简单查询:SIMPLE - 复杂查询:PRIMARY(最外面的 SELECT)、DERIVED(用于 FROM 中的子查询)、UNION(UNION 语句的第一个之后的 SELECT 语句)、UNION RESUlT(匿名临时表)、SUBQUERY(简单子查询) |
| table | 表名 |
| partitions | |
| type | 关联类型或访问类型,即 MySQL 决定的如何去查询表中的行的方式 |
| possible_keys | 查询可能会用到的索引 |
| key | 显示 mysql 决定采用哪个索引来优化查询 |
| key_len | 显示 mysql 在索引里使用的字节数 |
| ref | 根据索引返回表中匹配某单个值的所有行 |
| rows | 为了找到所需的行而需要读取的行数,估算值,不精确。通过把所有 rows 列值相乘,可粗略估算整个查询会检查的行数 |
| filtered | 按表条件筛选的行的百分比 |
| Extra | 额外信息 |
重点: type 显示的是访问类型,是较为重要的一个指标,结果值从好到坏依次是:
1 | NULL |
并发控制
锁机制
读锁:共享锁,也称为 S 锁,只读不可写(包括当前事务),多个读互不阻塞
写锁:独占锁,排它锁,也称为 X 锁,写锁会阻塞其它事务(不包括当前事务)的读和写
S 锁和 S 锁是兼容的,X 锁和其它锁都不兼容
锁粒度:
- 表级锁:MyISAM
- 行级锁:InnodB
实现
- 存储引擎:自行实现其锁策略和锁粒度
- 服务器级:实现了锁,表级锁,用户可显式请求
分类:
- 隐式锁:由存储引擎自动施加锁
- 显式锁:用户手动请求
锁策略:在锁粒度及数据安全性寻求的平衡机制
显式使用锁
1 | # 加锁 |
通常在备份前加全局读锁
事务 Transactions
事务:一组原子性的 SQL 语句,或一个独立工作单元
事务日志:记录事务信息,实现 undo,redo 等故障恢复功能
事务特性 ACID
- A:atomicity 原子性;整个事务中的所有操作要么全部成功执行,要么全部失败后回滚
- C:consistency 一致性;数据库总是从一个一致性状态转换为另一个一致性状态
- I:Isolation 隔离性;一个事务所做出的操作在提交之前,是不能为其它事务所见;隔离有多种隔离级别,实现并发
- D:durability 持久性;一旦事务提交,其所做的修改会永久保存于数据库中
事务命令
显式启动事务:
1 | BEGIN |
结束事务:
1 | #提交 |
自动提交:
1 | set autocommit={1|0} |
默认为 1,为 0 时设为非自动提交,建议:显式请求和提交事务,而不要使用“自动提交”功能
事务支持保存点:…
查看事务:
1 | #查看当前正在进行的事务 |
事务隔离级别
MySQL 支持四种隔离级别,事务隔离级别从上至下更加严格,默认为 REPEATABLE-READ
| 隔离级别 | 脏读 | 不可重复读 | 幻读 | 加读锁 | |
|---|---|---|---|---|---|
| READ UNCOMMITTED | 读未提交 | 可以出现 | 可以出现 | 可以出现 | 否 |
| READ COMMITTED | 读提交 | 不允许出现 | 可以出现 | 可以出现 | 否 |
| REPEATABLE READ | 可重复读 | 不允许出现 | 不允许出现 | 可以出现 | 否 |
| SERIALIZABLE | 序列化 | 不允许出现 | 不允许出现 | 不允许出现 | 是 |
MVCC 和事务的隔离级别:
MVCC(多版本并发控制机制)只在 REPEATABLE READ 和 READ COMMITTED 两个隔离级别下工作。其
他两个隔离级别都和 MVCC 不兼容,因为 READ UNCOMMITTED 总是读取最新的数据行,而不是符合当前
事务版本的数据行。而 SERIALIZABLE 则会对所有读取的行都加锁
指定事务隔离级别:
1 | # 变量 |
死锁:两个或多个事务在同一资源相互占用,并请求锁定对方占用的资源的状态
什么是脏读和幻读
脏读
脏读是指当一个事务正在访问数据,并且对数据进行了修改。而这种修改还没有提交到数据库中,这时,另外一个事务也访问了这个数据,然后使用了这个数据。
例子: 1.财务将董震的工资从 1000 修改成了 8000(但未提交事务) 2.此时应董震读取自己的工资发现自己的工资变成了 8000,高兴的上蹦下跳 3.接着财务发现操作有误,回滚了事务,此时董震的工资又变成了 1000,此时董震记取的工资 8000 是一个 脏数据
幻读
幻读是指当事务不是独立执行时发生的一种现象,例如第一个事务对一个表中的数据进行了修改,这种修改涉及到了表中的全部数据行。同时,第二个事务也修改了这个表中的数据,这种修改是向表中插入一行新数据。那么,以后就会发生操作第一个事务的用户发现表中还有没有修改的数据行,就好像发生了幻觉一样。
例子:
目前公司员工工资为 1000 的有 10 人
- 事务 1 读取所有的员工工资为 1000 的员工。
- 2.这时事务 2 向 employee 表插入了一条员工纪录,工资也为 1000
- 3.事务 1 再次读取所有工资为 1000 的员工,共读取了 11 条记录。
解决方法:如果在操作事务完成数据处理之前,任何其它事务都不可以添加新数据。
日志管理
MySQL 支持丰富的日志
~/.mysql_history
~/.mysql_history 文件记录了所有的操作数据库的命令
事务日志
transaction log
事务日志的写入类型为“追加”,因此其操作为“顺序 IO”;通常也被称为:预写式日志 write ahead logging
事务日志分类两部分:redo 和 undo
redo log:实现 WAL(Write Ahead Log),数据更新前先记录 redo log;
redo 日志存储在 ib_logfile0, ib_logfile1…文件中
undo log:保存与执行的操作相反的操作,用于实现 rollback;
undo 日志和数据存储在一起,都在 ibdata1 或 tbl_name.ibd 文件中,当 DB 写压力比较大的时候,可以设置开启独立的 undo 表空间
相关配置选项:
1 | innodb_log_file_size 50331648 # 每个日志文件大小 |
innodb_flush_log_at_trx_commit=0|1|2
- 0:事务提交到 mysql 的日志缓冲区,每秒刷新到磁盘一次,提高性能,但是 mysql 服务崩溃可能会丢失最后一秒的事务
- 1:默认值,每次提交事务都刷新到磁盘,完全遵守 ACID 特性
- 2:事务提交到 OS 的缓冲区,每秒刷新到磁盘一次,性能比 0 略差,操作系统崩溃可能丢失最后一秒的事务
推荐设置为 2
设置为 1,同时 sync-binlog = 1,表示最高级别的容错
错误日志
- mysqld 启动和关闭过程中输出的事件信息
- mysqld 运行中产生的错误信息
- event scheduler 运行一个 event 时产生的日志信息
- 在主从复制架构中的从服务器上启动从服务器线程时产生的信息
错误文件路径:
1 | [mysqld] |
错误文件记录警告的级别:
1 | [mysqld] |
通用日志
通用日志记录对数据库的通用操作,包括 错误的 SQL 语句,如果数据库的使用非常频繁,通用查询日志将会占用非常大的磁盘空间,对系统性能影响较大。一般情况下,数据管理员可以删除很长时间之前的通用查询日志或关闭此日志,以保证 MySQL 服务器上的硬盘空间。
通用日志可以保存在 file(默认)或 table(mysql.general_log 表)
通用日志相关设置
1 | # 默认是关闭的 |
慢查询日志
记录执行查询时长超出指定时长的操作
慢查询相关设置选项:
1 | # 开启或关闭慢查询,支持全局和会话,只有全局设置才会生成慢查询文件 |
慢查询分析工具 mysqldumpslow
1 | mysqldumpslow [ OPTS... ] [ LOGS... ] |
范例:
1 | [root@4710419222 mysql]# mysqldumpslow --help |
profile 工具
profile 工具可以对一条 SQL 的性能进行分析,开启 profile 功能后,所有查询包括错误的语句都会记录在内。
1 | [mysqld] |
profile 不能通过设置配置文件的方式自动启动,只能通过设置变量的方式会话启动
1 | 10:13:33(root@localhost) [(none)]> set @@profiling=1; # 开启profile |
set profiling=0 或者退出会话自动关闭 profile
范例:
1 | # 1. 查看profile缓存的sql语句 |
除了可以查看 CPU 的耗时情况,还支持分析很多类型,例如:
| 分析类型 | 说明 |
|---|---|
| all | 显示所有性能信息 |
| block io | 显示块 IO(块的输入输出)的次数 |
| context switches | 上下文切换相关开销 |
| cpu | 显示用户和系统的 cpu 的耗时情况 |
| ipc | 显示发送和接受的消息数量 |
| memory | 暂时还没有这个选项,未来可能有 |
| page faults | 显示主要和次要的页面故障 |
| swaps | 显示 swap 的次数 |
分析多个类型时,使用逗号分割,例如:show profile cpu,block io for query 10;
二进制日志(备份)
生产中,上述日志都可以不开启,但是二进制日志一定要开启,因为二进制日志我们是当备份用的
- 记录导致数据改变或潜在导致数据改变的 SQL 语句,例如 SELECT 语句是不会被记录的
- 记录已提交的事务,不会记录脏数据
- 不依赖于存储引擎
注意区分二进制日志和事务日志
相关配置选项
1 | [mysqld] |
log-bin = /data/mysqlbinlog/mysql-bin:
1 | [root@c71 mysqlbinlog]$ll ./mysql-bin.* |
binlog-format = STATEMENT | ROW | MIXED:
- statement:基于语句记录,日志量较少,但生产中不推荐使用,因为二进制日志是用来备份的,如果记录了类似
update table set time = now();的语句,那将来恢复备份的时候 now()值就变了 - row:基于行记录,日志量较大,例如上面的 update 操作,statement 模式原封不动的只记录一条语句,而 row 模式则记录每一条数据的更改,并且不会记录 now(),而是转成确切时间记录,所以 row 模式更加安全,生产中推荐使用
- mixed:混合模式,让系统根据情况自行切换 statement 和 row 模式,这样即相对节省硬盘空间,也安全,但是万一系统判断错了呢,所以还是推荐使用 row 模式,确保万无一失
max-binlog-size = 1073741824:以下三种情况会切换二进制日志(就是生产一个新的二进制日志文件,后面的数据库更改操作记录在新的二进制日志文件中)
- 重启数据库
- 二进制日志文件达到了 max_binlog_size 设置的值
- 执行
flush logs;命令主动刷新所有日志
binlog-cache-size = 1048576max-binlog-cache-size = 18446744073709547520
当事务过大,所需缓存超过了binlog-cache-size分配的内存大小,会使用临时文件,如果超过了max-binlog-cache-size限制的最大值,则直接报错
1 | 10:32:47(root@localhost) [(none)]> show global status like 'bin%'; |
相关变量
1 | 09:40:36(root@localhost) [(none)]> select @@sql_log_bin; |
log-bin 配置选项是全局级别的,sql_log_bin 变量是会话级别的
相关工具和命令
mysqlbinlog:二进制日志的客户端命令工具,支持离线查看二进制日志
1 | mysqlbinlog [options] log-files |
mysqlbinlog 可以用于简单的备份
1 | # 备份 在Mysql5.5以下版本使用mysqlbinlog命令时如果报错,就加上"--no-defaults"选项 |
PURGE:清除指定二进制日志
1 | PURGE { BINARY | MASTER } LOGS { TO 'log_name' | BEFORE datetime_expr } |
1 | PURGE BINARY LOGS TO 'mariadb-bin.000003'; # 删除mariadb-bin.000003之前的日志 |
RESET MASTER:删除所有二进制日志,index 文件重新计数,一般在完成备份后,可以执行此操作